Analisis Sentimen Berbasis Aspek untuk Ulasan Berbahasa Indonesia
Tim 2 orang · Proyek mata kuliah NLP (COMP6885) · BINUS · 2025/26
Ulasan berbahasa Indonesia yang informal dan campur bahasa sering menilai sebuah aspek tanpa menyebut namanya.
- Baca ulasan
- Temukan aspeknya
- Nilai satu per satu
“pengiriman sangat lama hampir semingguPengiriman tapi harganya murahHarga dan barangnya berkualitas bagusKualitas produk”
- Kualitas produkPositif98,7%
- HargaPositif98,4%
- PengirimanNegatif96,2%
- Layanan penjualTidak disebut98,9%
- KemasanTidak disebut98,3%
Walkthrough output model yang sebenarnya. IndoBERT, 7 Okt 2026. Penanda frasa ditambahkan manual.
- Peran saya
- Memimpin pengembangan model transformer dan evaluasinya. Ikut menganotasi seluruh 1.500 ulasan.
- Tim
- 2 mahasiswa: Valentino Allen Prasetyo, Michael Hendrilie
- Stack
- Python, Transformers, Streamlit
Masalah
Rating bintang tidak menunjukkan bagian mana dari pesanan yang disukai pembeli. Ulasan e-commerce berbahasa Indonesia membuatnya lebih sulit: bahasanya informal, bercampur antara bahasa Indonesia dan Inggris, dan sering menilai sebuah aspek tanpa menyebutnya.
“Barang sampai peyok” adalah opini negatif tentang kemasan, walaupun kata kemasan sama sekali tidak muncul.
Pendekatan
Kami menganotasi 1.500 ulasan Tokopedia (7.474 pasangan ulasan–aspek) untuk lima aspek: kualitas produk, harga, pengiriman, layanan penjual, dan kemasan. Setiap pasangan mendapat satu dari empat kelas: positif, negatif, netral, atau tidak disebut. Setiap ulasan kami label secara terpisah, lalu perbedaan label kami selesaikan bersama.
Mengikuti Sun et al., setiap ulasan dipasangkan dengan pertanyaan tentang satu aspek, sehingga satu model menangani deteksi aspek dan sentimen sekaligus. Empat model dilatih dengan setup yang sama persis: TF-IDF dengan SVM, TF-IDF dengan logistic regression, IndoBERT, dan IndoBERTweet.
Paper mata kuliah (tidak dipublikasikan), Natural Language Processing (COMP6885), BINUS, semester ganjil 2025/26.

Hasil
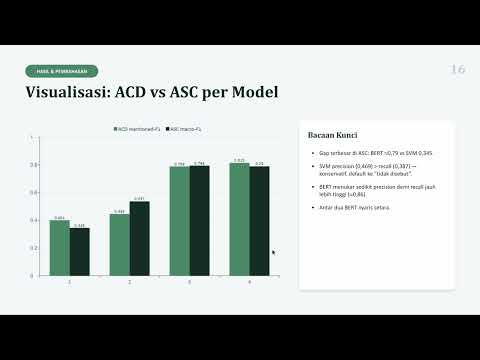
IndoBERT dan IndoBERTweet tidak berbeda secara statistik (p = 0,13), jadi pre-training dengan data tweet tidak membantu.
Aplikasinya mengembalikan prediksi per aspek dalam waktu kurang dari satu detik per ulasan.
| Model | Macro-F1 |
|---|---|
| IndoBERT | 0,794 |
| IndoBERTweet | 0,790 |
| TF-IDF + logistic regression | 0,537 |
| TF-IDF + SVM | 0,345 |
| Aspeknya | Recall |
|---|---|
| Disebut dalam ulasan | 0,907 |
| Tersirat, tidak disebut | 0,899 |
Yang saya kerjakan
Saya memimpin penentuan lingkup proyek dan pertanyaan riset, pipeline preprocessing teks, formulasi sentence-pair empat kelas, fine-tuning IndoBERT dan IndoBERTweet, serta seluruh evaluasi: deteksi aspek, sentimen, aspek implisit, uji lintas domain, dan uji McNemar. Saya juga mengerjakan analisis error, video demo, dan repositorinya.
Michael Hendrilie memimpin pengumpulan dan pembersihan dataset, baseline TF-IDF, aplikasi Streamlit, dan slide. Kami menganotasi seluruh 1.500 ulasan bersama dan menulis paper bersama.
Keterbatasan
Kesepakatan antar-anotator tidak diukur. Label bergantung pada pelabelan ganda yang disepakati bersama.
Semua ulasan berasal dari Tokopedia, jadi platform lain belum diuji.
Kelas netral dihapus untuk pengiriman, layanan penjual, dan kemasan, sehingga ketiga aspek itu praktis hanya punya tiga kelas.
Harga hanya disebut sepuluh kali di test set, jadi skor per aspeknya hanya bersifat indikatif.
Tautan
- Kode, data, dan model
- Video demo
Video demo · YouTube - Paper mata kuliah (tidak dipublikasikan) PDF